速览
这篇论文解决的是一个很具体的工程痛点:长程、多轮的 agentic 推理里,模型生成的 action 很短,但工具返回的观测(trace、文档、搜索结果)很长。上下文因此被输入主导 —— 既要把这些新 token 高效地 prefill 进网络,又要把历史 KV cache 压得足够小,还要能精确地检索回很远的证据。
一句话概括它的做法:HySparse2 = YOCO 式的 self-decoder / cross-decoder 骨架 + 两级 KV 共享。外层 KV Bridging 让 cross-decoder 的全注意力层直接用 self-decoder 全注意力层的输入隐状态投影出自己的 K/V;内层 KV Reuse 让同一 block 内的稀疏层复用全注意力层的 KV cache 与选择索引。两级合起来的效果是:cross-decoder 的每一份 KV cache 都能由 self-decoder 的隐状态造出来,所以 prefill 建完 cache 就可以直接退出,不必再跑 cross-decoder 的 24 层。
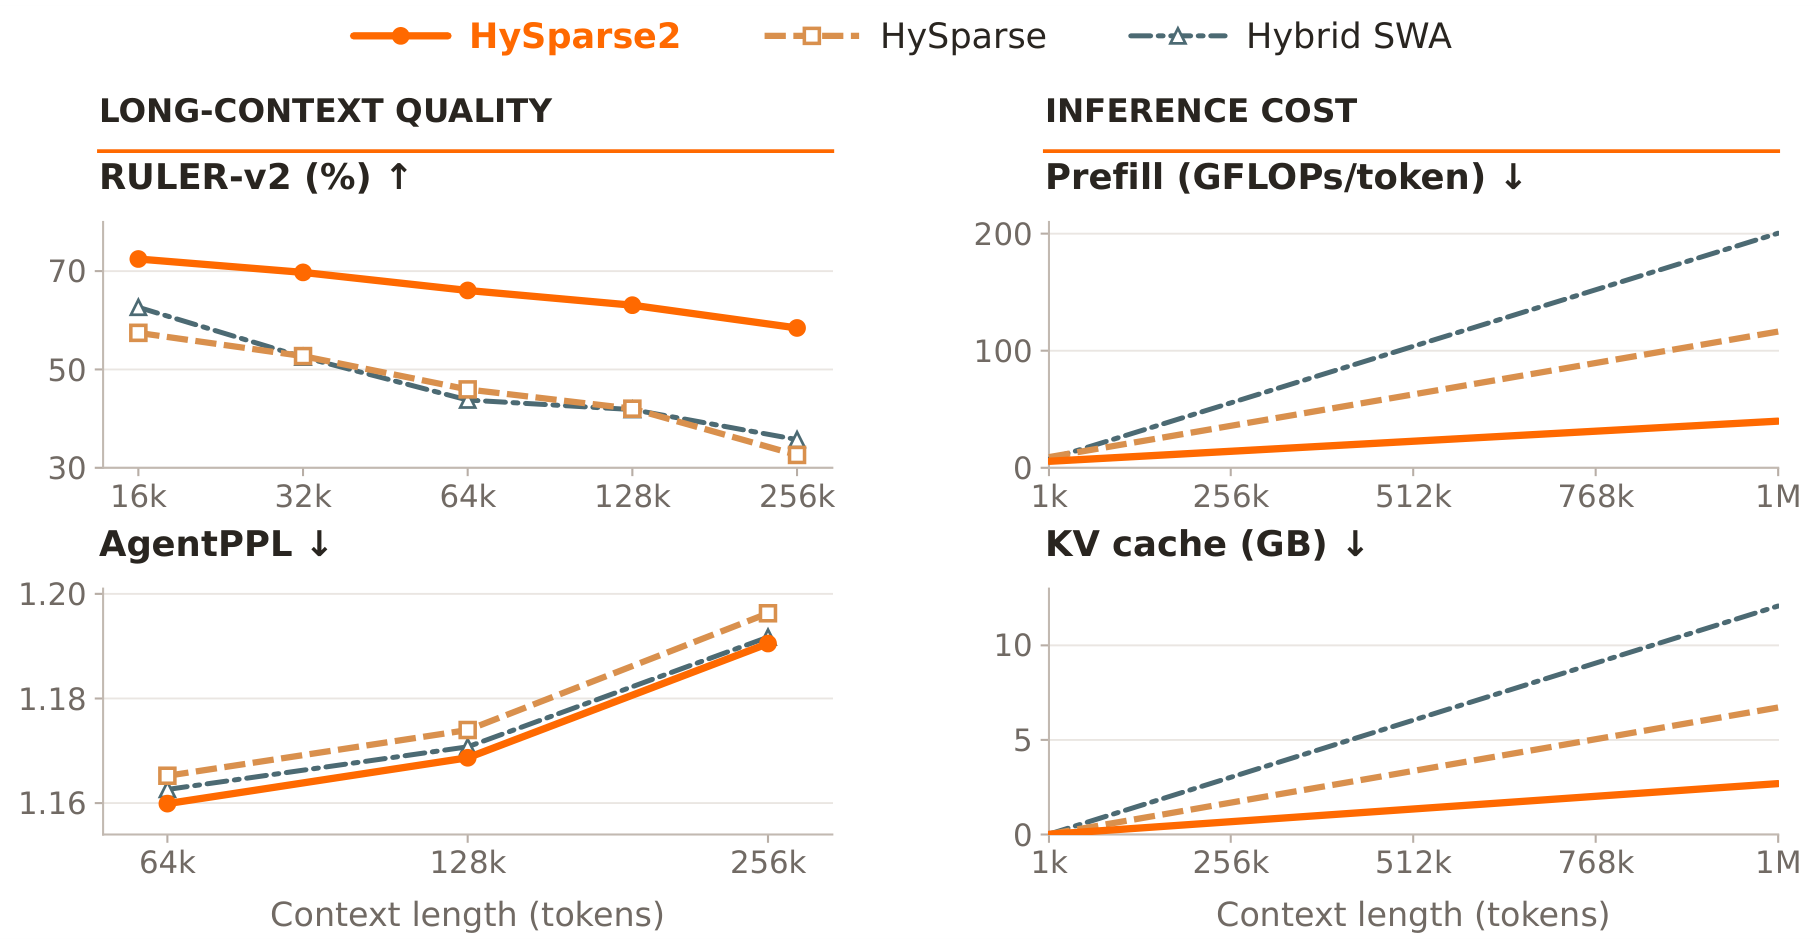
论文的四个图分别对应"质量"和"成本"两条主线,先看这张总览:
💡 点击任意图片可查看 300 DPI 原始高清大图,再次点击或按 Esc 关闭。
背景与动机:三条需求线
论文的第 2 章把动机铺成三条线,后面所有设计都能对回这三条线上。
2.1 高效 prefill:光省注意力还不够
多轮 agentic 推理让推理越来越"输入主导"——一次工具返回可能比触发它的 action 长出几个数量级。论文特别强调一点:只降低注意力本身的计算量,并不能消除把这些 token 传播过整个 backbone 的代价。也就是说,即使每层的注意力算子变便宜了,层数 × 每层的前馈仍然要一遍遍算过去。
已有的跨层 KV-cache 共享是对着这个问题的:YOCO(Sun et al., 2024)用 self-decoder 构造一份全局 KV cache 给 cross-decoder 复用,于是 prefill 的 cache 构造可以在 self-decoder 之后退出;Gemma 3n(Sanseviero and Ballantyne, 2025)采用了相关的跨层 KV 共享来改善 prefill 效率。HySparse(Gao et al., 2026)则在 hybrid 稀疏块内部做跨层共享:每个全注意力层把自己的全局 KV cache 与 top-$k$ 块索引交给后续的稀疏层,但 —— 论文点明这句 —— prefill 仍然要执行全部层。
2.2 KV cache 压缩的四个维度
论文把 KV cache 压缩归成四条轴,这个分类法本身值得记下来,因为它决定了本文站在哪一格:
- Head 维:用 GQA/MQA 让多个 query 头共享 KV 头(Ainslie et al., 2023;Shazeer, 2019),或如 MLA 把 KV 压进隐状态(Liu et al., 2024a);
- Sequence 维:把多个 token 压成更少的 cache 条目(DeepSeek-AI et al., 2026);
- Layer 维:跨层共享 KV cache(Brandon et al., 2024;Sun et al., 2024);
- Precision 维:降低缓存键值的数值精度(Hooper et al., 2024;Liu et al., 2024b)。
论文的判断是:先前工作集中在 head / sequence / precision 三条轴上的层内压缩,而 HySparse2 要推的是跨层共享这一格 —— 而且不是单指一层,而是"外层 KV Bridging + 内层 KV Reuse"两级同时做。
2.3 稀疏选择的粒度:一个精度与效率的固有取舍
稀疏注意力把每个 query 限制到一部分 KV 条目上(Child et al., 2019),选择粒度决定精度/效率的平衡点。HySparse 当初选 block-level 是实用主义折中:评测显示精度没有明显劣势,而且规则的块结构利于高效 kernel。
但论文指出,现代 agentic 负载是长程多轮轨迹,需要从很长的历史里精确检索。在这种模式下,块级选择表现出明显的精度劣势,而 token-level 选择能更忠实地取回相关证据。同时,近期稀疏 kernel 的进展(Wang et al., 2025)让 token 级实现变得可行 —— 这两条合起来,构成了本文从 block 改到 token 的理由。
设计出发点:三个取舍
第 3 章的技术内容可以读成三次取舍。把取舍读清楚,比记住架构图更重要 —— 因为其中第二个取舍是整篇论文里最不可替代的一步。
取舍一:外层共享只发生在全注意力层之间
KV Bridging 有一条硬边界:只在 self-decoder 与 cross-decoder 的全注意力层之间建立,不碰 SWA 层、也不碰稀疏层。原因写在式 (1) 旁边的措辞里 —— 每一对 $(i, j)$ 是全注意力层对全注意力层。这样做的直接好处是:两个 decoder 可以采用不同的混合比例,一个 self-decoder 全注意力层可以同时供给多个 cross-decoder 全注意力层(下面的 Figure 2 里就是 1 供 4)。
取舍二:去掉独立 SWA 分支,把最近窗口"塞进"稀疏选择
这是全文最关键的论证,值得完整复述一遍。HySparse 的稀疏层里有一条独立的 gated SWA 分支来做局部建模。论文指出:如果 cross-decoder 里保留这样一条独立 SWA 分支,cross-decoder 就必须用自己的隐状态做投影,来构造一个窗口大小的 KV cache 后缀;而这个后缀所依赖的隐状态,又取决于更早层的隐状态集合 —— 论文称之为 级联的 SWA 依赖(cascading SWA dependency),它所需的 token 后缀会随深度线性增长,远长于窗口本身。
于是只有两条路:要么在 prefill 时把这些状态算出来(那 cross-decoder 就完全无法跳过),要么用 bounded replay 之类的方法去近似(DeepSeek-AI, 2026)。HySparse2 选了第三条路:按结构消除这个依赖 —— 把"最近 128 个 token"直接强制写进稀疏选择集合,局部性由复用同一份全注意力 KV cache 来提供,不再需要自己的隐状态。论文顺带指出,这一改动还省掉了门控 baseline 里那条分支的独立投影参数量。
取舍三:保留少量全注意力层,并且让它们兼任 indexer
HySparse2 和 HySparse 都保留少量全注意力层,论文的理由有两层。其一,全注意力对模型质量仍然重要。其二,这些层同时充当 indexer:用精确的注意力分数为后续稀疏层提供 oracle 式的 token 选择。这带来一个很干净的训练属性 —— 端到端原生训练,不需要单独的 indexer 模块,也不需要为此训练一个辅助蒸馏目标(对比 SeerAttention(Gao et al., 2024)、DeepSeek-AI et al. (2025)需要蒸馏 indexer 的路线)。
但全注意力终究昂贵,所以比例要压得低。论文还给出了两个未来方向:一是在后训练阶段用轻量 indexer + 稀疏注意力去近似那些保留下来的全注意力层;二是让计算分配更偏稀疏 —— 例如减少全注意力层的 query 头数、增加稀疏层的 query 头数。论文同时强调了一个部署事实:HySparse2 里 prefill 的 KV-cache 构造只需要一个全注意力层。
方法:两级 KV 共享到底怎么共享
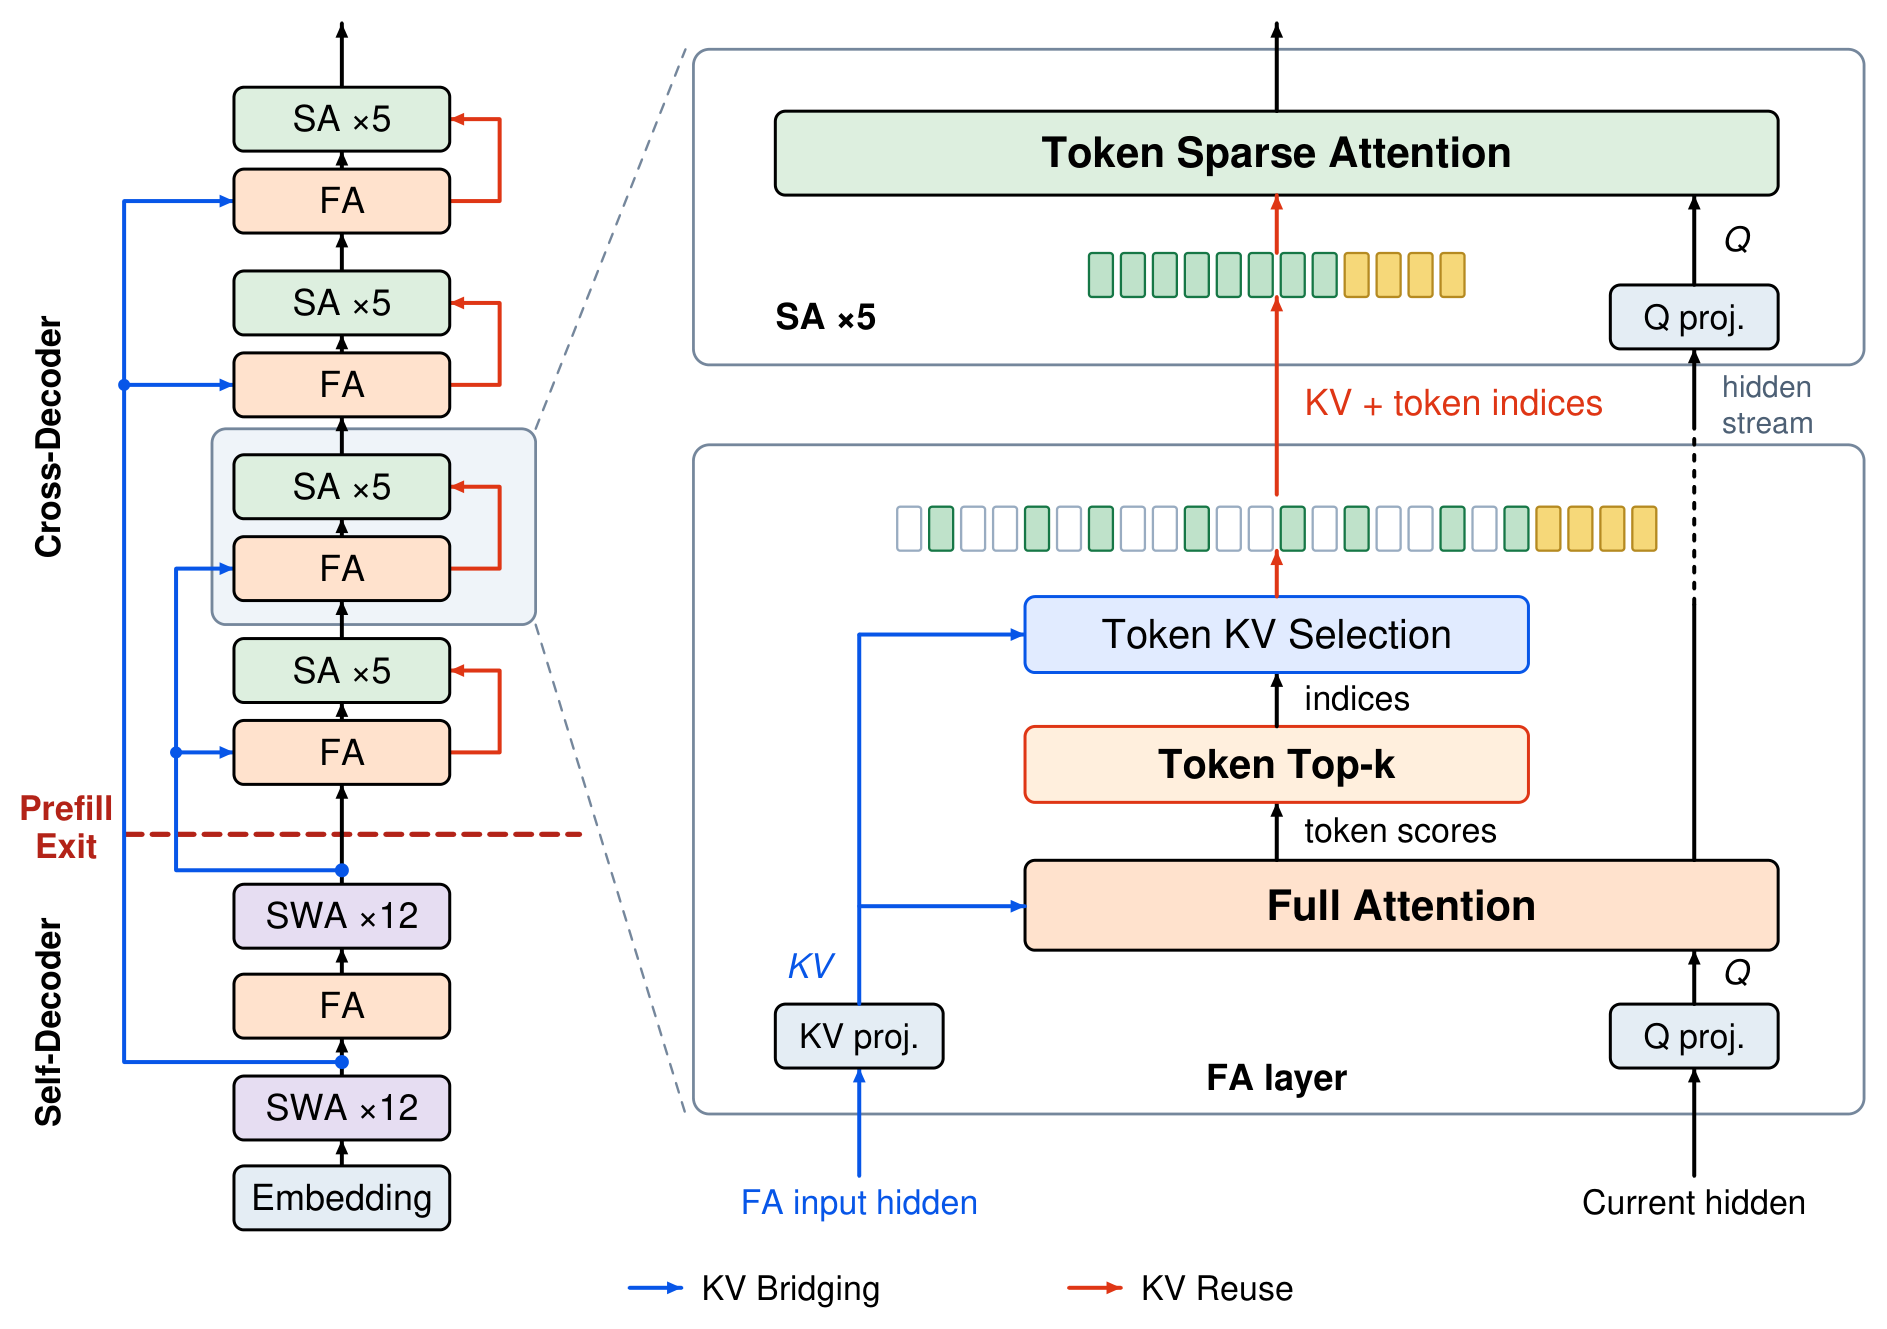
HySparse2 的骨架沿用 YOCO:backbone 被切成 self-decoder 和 cross-decoder 两段,两段都用混合注意力。区别在于混合的配方 —— self-decoder 是全注意力 + 滑窗注意力,负责局部建模;cross-decoder 是全注意力 + 稀疏注意力,负责全局检索。共享则分两层:外层 KV Bridging 跨两个 decoder,内层 KV Reuse 落在每个 hybrid block 内部。下面这张图同时画了这两层:
4.1 外层:KV Bridging
取一对全注意力层 $(i, j)$,$i$ 在 self-decoder、$j$ 在 cross-decoder。论文定义 cross-decoder 层的 K、V、Q 为:
读这个式子有三处要点。第一,桥接的来源是 $H_i^{\text{self}}$,也就是 self-decoder 全注意力层的输入隐状态,不是它的输出 —— 图 2 里的标注也正是 "FA input hidden"。第二,K 和 V 的来源是别人的隐状态,但 projection 是自己的:$j$ 层有自己的 $\operatorname{Proj}_j^{K}$、$\operatorname{Proj}_j^{V}$,所以即便多层共享同一个隐状态来源,各层构造出的 KV cache 依然是不同的。第三,Q 仍然来自自己的当前隐状态 $\operatorname{Proj}_j^{Q}(H_j^{\text{cross}})$,注意力算的仍是本届 token 与共享历史之间的关系。
这三点的组合让"一个 self-decoder 全注意力层供给多个 cross-decoder 全注意力层"在数学上无歧义 —— 供给的是源隐状态,而不是已经被投影好的 K/V,所以每一层仍然可以有自己的 KV 表示。
4.2 内层:KV Reuse 的两处改造
HySparse2 对 HySparse 的 KV Reuse 做了两处修改,两处都在第 3.3 节说明。
改造一:选择粒度从 block 换成 token
做法很直接:在全注意力层上对单个 token 做 top-$k$ 选择,后续稀疏层复用这些被选中 token 的 KV 条目。动机来自 2.3 节的判断 —— 长程多轮的 agentic 任务需要更精确的检索。第 4.3 节的消融专门验证这件事。
改造二:删掉独立 SWA 分支,改为强制局部窗口
在一个 block 内,选择集合由两部分拼成:先是最近的若干 token 构成的局部窗口(永远入选),然后是窗口之外得分最高的若干个 token。两个集合都从全注意力层的 KV cache 里读,再被后续的稀疏层复用。论文给出的配置是 128 个强制局部 token + 1,024 个全局 token(即 $k_{\text{local}} = 128$、$k_{\text{global}} = 1024$)。
这里可以对照三个模型的局部性处理方式:Hybrid SWA 用 128 token 的滑动窗口;HySparse 用"64-token 块里选 1,024 个全局 token + 一条独立的 128-token SWA 分支,靠门控融合";HySparse2 则把 128 token 直接放进选择集合里。
4.3 把配置落到层号上:49 层的走查「整理」
论文没有画层号表,但把 Figure 2 的方框数与正文的 49 层对上,可以得到一个很能说明问题的读数:
- self-decoder = 25 层:SWA×12 → FA → SWA×12;其中只有 1 个全注意力层;
- cross-decoder = 24 层:(FA + SA×5) 重复 4 组,即 4 个全注意力层 + 20 个稀疏层;
- 合计 $25 + 24 = 49$ 层,其中 SWA 24 层、SA 20 层、FA 5 层 —— FA 层的总数 5 与 Table 1 给出的"#Full = 5"一致。
把这几个数字连起来读:全模型只有 5 个全注意力层,而 self-decoder 那 1 个要同时供给 cross-decoder 的 4 个 —— 这就是"不同混合比例、一对多桥接"在图上的样子;prefill 需要跑的 25 层里,真正做全注意力的只有 1 层。
推理系统:分离式部署与推测解码
第 3.5 节把架构性质翻译成部署方案,这部分很短但信息密度高,直接关系到"这个设计在真实服务里值多少钱"。
5.1 Prefill–Decode 分离:prefill 节点只装半个模型
在 prefill–decode 分离部署下,HySparse2 的 prefill 节点只需要承载 self-decoder 加 KV Bridging 的投影。对 Figure 2 那个 49 层模型,这意味着只部署前 25 层,prefill 节点的显存需求近乎减半。又因为 self-decoder 的 SWA-to-full-attention 比例很高,这 25 层里只有 1 层做全注意力。
还有一个容易忽略的细节:论文选择在 prefill 节点上把 cross-decoder 的全注意力 KV cache 也算出来,再传给 decode 节点 —— 理由是投影后的 KV cache 比源隐状态更小,传 KV 比传隐状态划算。这是一个典型的"用计算换传输"的取舍,也解释了为什么 KV Bridging 要用各自的投影而不是简单地传隐状态。
5.2 推测解码:预训练用 MTP,后训练可换更大 drafter
预训练阶段,HySparse2 使用单个 MTP 层,条件在 self-decoder / cross-decoder 边界处的隐状态上,用来帮助收敛。到了后训练阶段,这一层可以被替换成一个更大的 DFlash 式 drafter(Chen et al., 2026),条件仍然是同一处边界隐状态。论文指出,这些隐状态很早就可用,因此有可能支撑异步起草与验证(Zhang et al., 2025)。
不过论文把话收得很紧:训练这个更大的 drafter、以及把异步执行与验证反馈协调好,都仍是未来工作。也就是说,5.2 节目前是一条设计上的可能性论证,不是已验证的结果。
实验:设置、预训练、后训练与成本账
评测分三块:总体对比(模型质量 + prefill FLOPs + KV cache 体积),以及三组消融(稀疏粒度、强制局部窗口、KV Bridging)。论文的编排逻辑很清晰 —— token 级选择换长上下文精度,强制窗口与 KV Bridging 换 prefill 成本,同时要求质量不掉。
6.1 设置:三个模型只差注意力设计
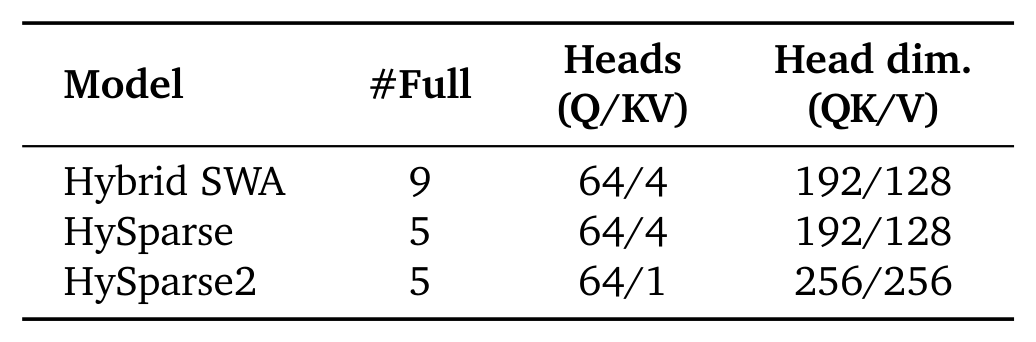
除非特别说明,实验都用 80B-A3B 的 MoE 模型:49 层 Transformer、hidden size 2,048,并使用一个简化版 mHC 变体(Xie et al., 2026;Zhu et al., 2025)。三个模型之间唯一的差别就是注意力设计:
还有几处配置细节值得记下来。HySparse2 的 self-decoder 里,SWA 层用部分 RoPE(64 个旋转维度,base 10,000),而全注意力与稀疏注意力层用 NoPE —— 因此论文强调,HySparse2 在长上下文扩展时不需要调整 RoPE。另外三个配置里所有稀疏层与 SWA 层都使用 sigmoid 输出门(Qiu et al., 2025)与可学习的 per-head sink bias(Agarwal et al., 2025)。
训练上,预训练约 500B tokens、上下文 32k;轻量后训练再加约 100B tokens,向数据混合中引入 agentic 数据,并把上下文延展到 256k。三个阶段内三个模型共享同一数据混合与训练日程。Muon 优化器(Jordan et al., 2024)+ WSD 日程,峰值学习率预训练 $10^{-3}$、后训练 $5\times10^{-5}$。总体对比同时报预训练与后训练结果,消融只报预训练结果。
评测分为四类:知识(MMLU、MMLU-Redux、C-Eval、CMMLU、TriviaQA)、推理(BBH、MATH、DROP、GSM8K、ARC-C、HellaSwag、WinoGrande)、代码(HumanEval+、MBPP+、Repo Code PPL)与长上下文(RULER、NoLiMa)。其中 Repo Code PPL 是内部基准,对含跨文件依赖的长代码仓库报告 byte perplexity,因此也间接探测长上下文建模能力。后训练阶段则聚焦两类指标:多轮检索(MRCR-v2、RULER-v2、GraphWalks)与长上下文似然(AgentPPL、LongPPL)。AgentPPL 是建立在多轮 agent 轨迹上的内部基准,对 1,000 条轨迹的 reasoning / tool-call / response 三段分别报告 byte perplexity;LongPPL(Fang et al., 2024)只在依赖长程上下文的被选 token 上算 perplexity,用了 349 个样本;MRCR-v2(Vodrahalli et al., 2024)是多轮检索,含 2/4/8 needle 三种设置;RULER-v2(Hsieh et al., 2025)覆盖 12 个子任务;GraphWalks(OpenAI, 2025)考多跳图遍历。检索类平均分对报告的各上下文长度等权平均。
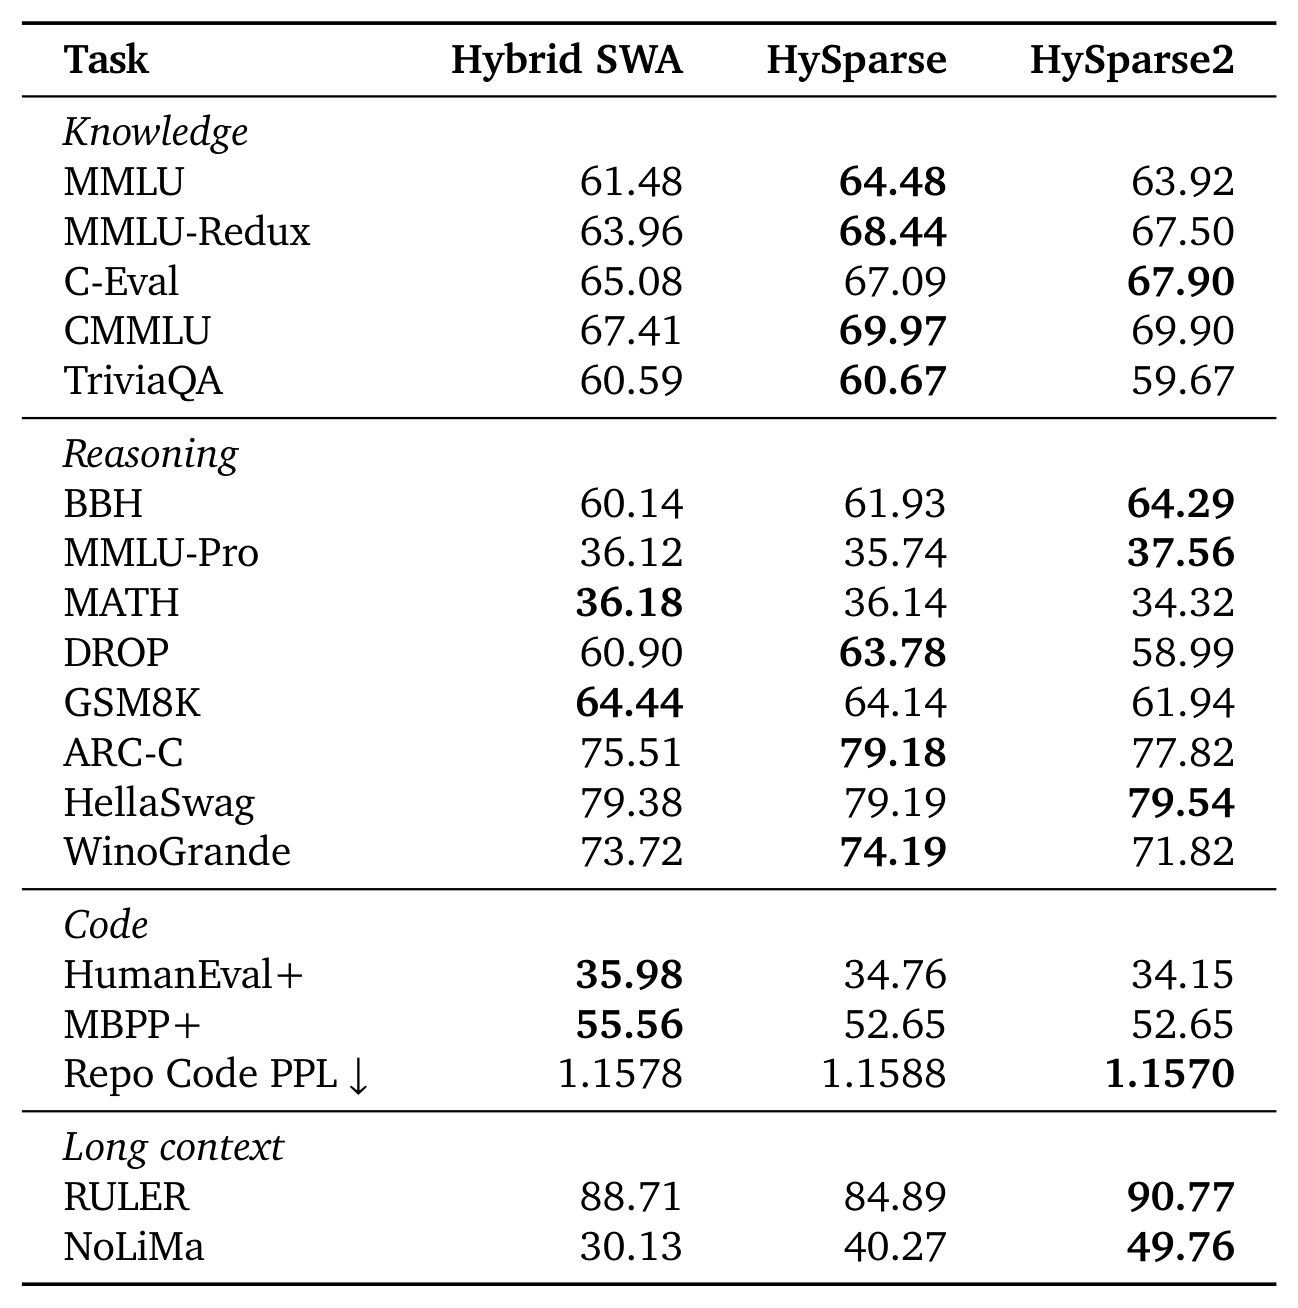
6.2 预训练:长上下文最强,通用能力是笔"混账"
6.3 后训练:四个指标、所有长度全面领先
经过同样约 100B tokens 的轻量后训练之后,结果变得干净得多:
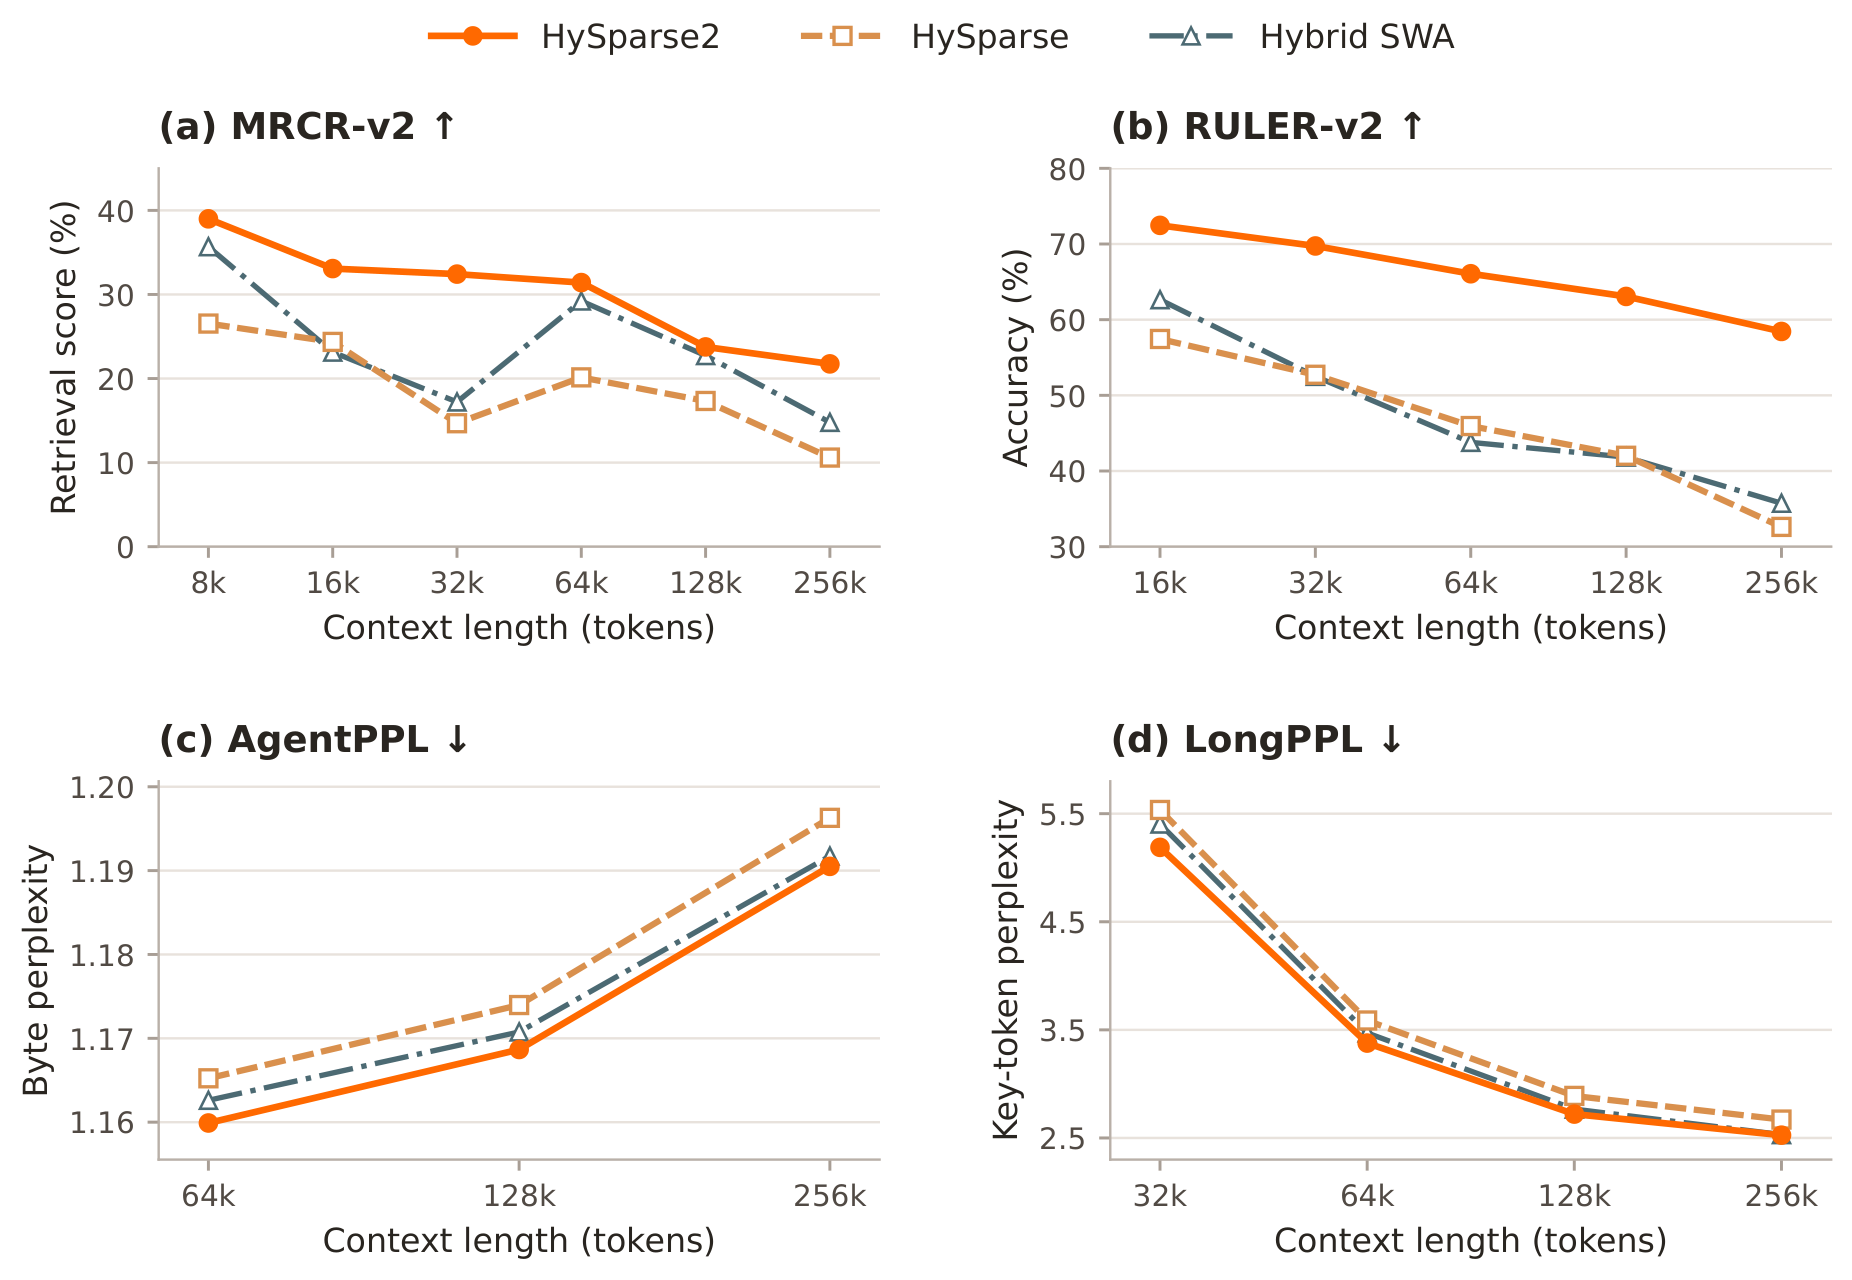
论文给出的平均增益:相对 HySparse,mean MRCR-v2 +11.30、RULER-v2 +19.81 个百分点;相对 Hybrid SWA 则是 +6.44 与 +18.65。并且 HySparse2 在整个评测范围内都取得更低的 AgentPPL 与 LongPPL,说明检索上的增益同时也伴随着长 agent 轨迹与上下文依赖 token 上更好的似然。
6.4 成本:prefill FLOPs 与 KV cache
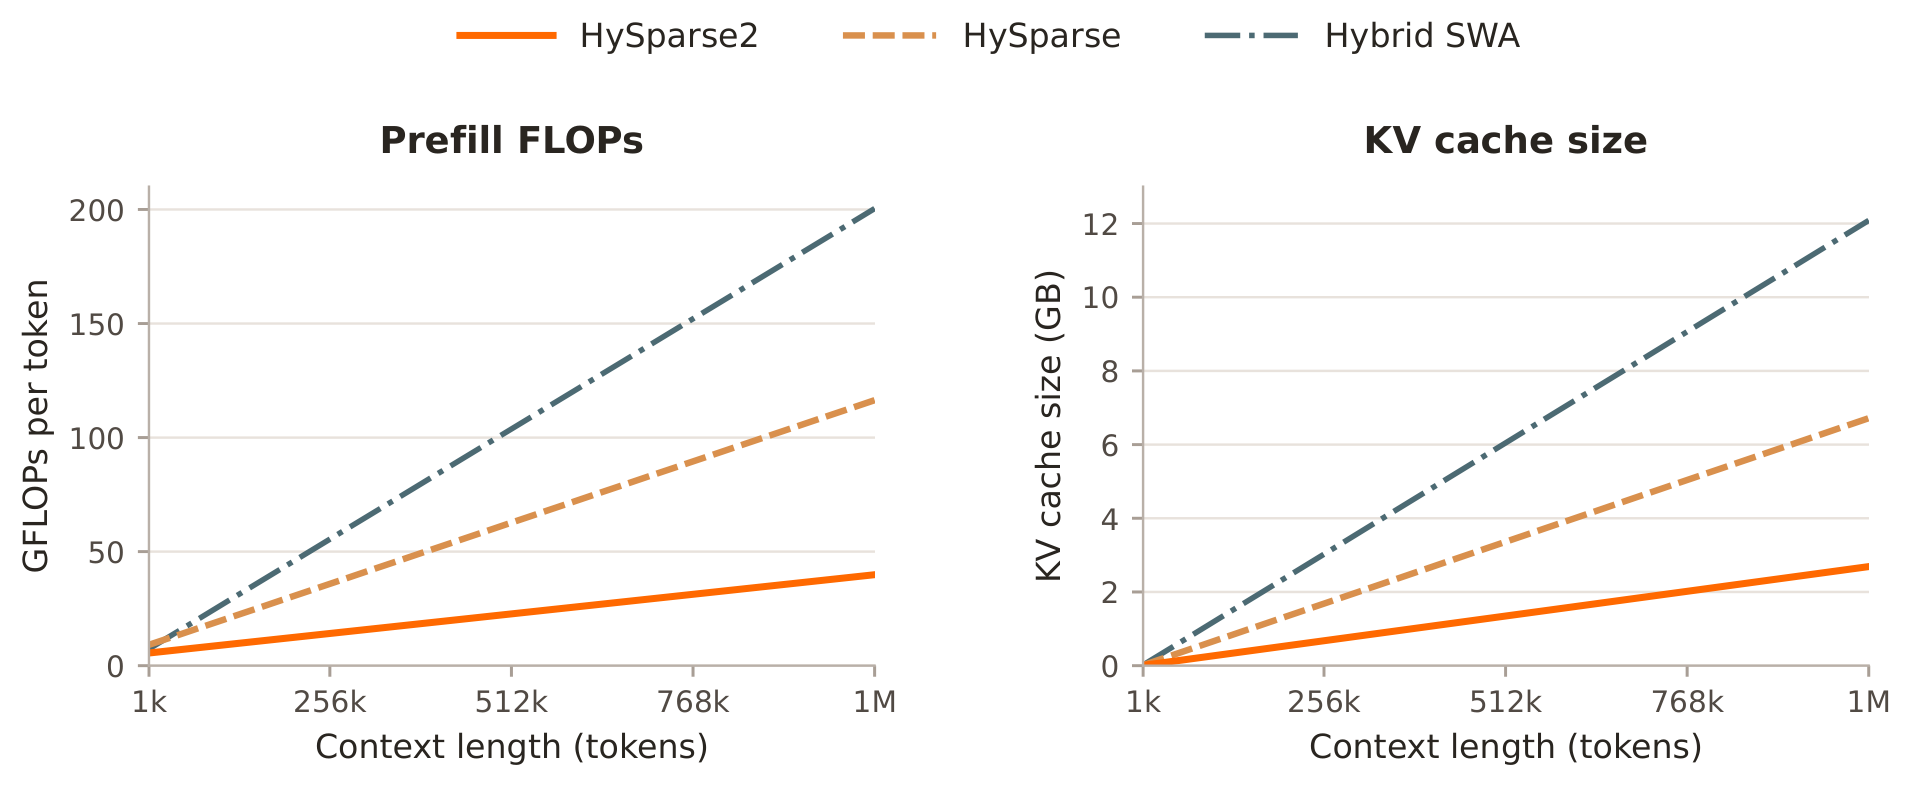
KV cache 账本走查「推算」
论文只给了三个总数,没给分项账本。但用 Table 1 的 KV head 配置可以自己核一遍,而核出来的结果恰好能验证一个重要的设计主张:
- 每 token 每层的 KV 字节数 = KV head 数 × (head dim K + head dim V) × 1 byte(FP8);
- HySparse2(MQA 64/1,head dim 256/256):$1 \times (256+256) = 512$ bytes/层/token;有 5 个 FA 层 → 2,560 bytes/token;
- HySparse(GQA 64/4,head dim 192/128):$4 \times (192+128) = 1{,}280$ bytes/层/token;5 个 FA 层 → 6,400 bytes/token;
- Hybrid SWA(同 GQA 配置):1,280 bytes/层/token;9 个 FA 层 → 11,520 bytes/token。
乘 1M token 得到 2.56 / 6.40 / 11.52 GB,对照论文的 2.69 / 6.72 / 12.09 GB。
三个数都对不上零头,但差的是同一个倍数(约 1.05×) —— 说明这是统一的口径或记账差异,不是结构差异。真正有信息量的是两两比值:推算的 $6{,}400/2{,}560 = 2.50$ 与 $11{,}520/2{,}560 = 4.50$,和论文数字算出的 $6.72/2.69 = 2.50$、$12.09/2.69 = 4.49$ 几乎完全吻合。
这验证了两件事:其一,三个模型的 KV cache 体积基本由「FA 层数 × KV head 配置」决定;其二,稀疏层没有引入任何常驻 KV cache —— 它们读的确实是同 block 全注意力层的那一份,这正是 KV Reuse 想要的账面效果。同时也要看清:HySparse2 相对 HySparse 的 2.50× 体积优势中,一部分来自 FA 层数之外的 MQA 改造;若把 KV head 也统一成 GQA 64/4,单靠 5 层 FA 对 9 层 FA 只能解释 $9/5 = 1.8\times$。
消融:三组对照回答三个问题
三组消融分别对应三个设计决定,而且都只报预训练结果(32k 训练上下文内),这一点在解读时很重要 —— 尤其是第一组,它的动机本来是 256k 的 agentic 场景。
7.1 粒度:token 级 vs block 级(同预算)
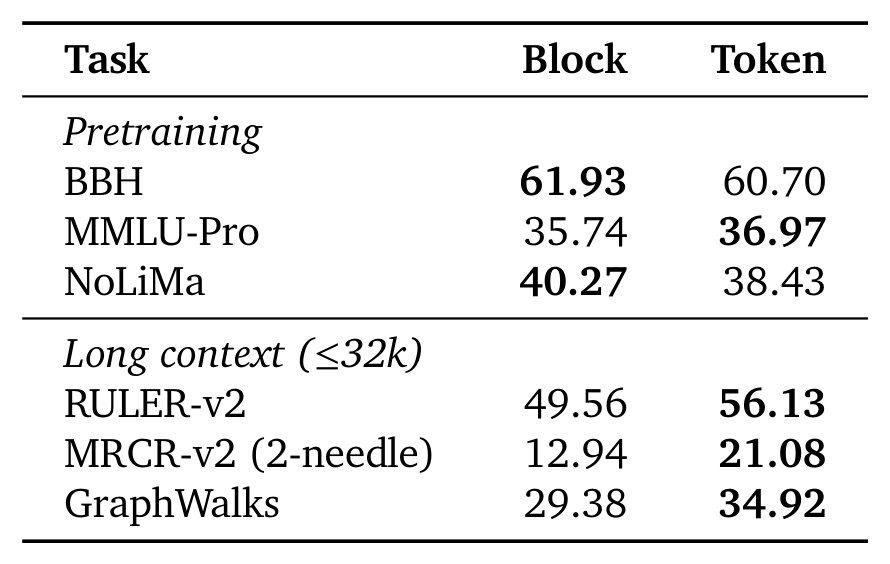
论文对增益的解释值得单独记一句:agent 轨迹反复交织着 reasoning、tool call 和返回的观测,回答所需的信息可能散布在好几轮里,还夹杂着角色分隔符与其他特殊 token(正是这些 token 标出了相关边界)。在固定预算下,为了保住其中一个 token 而选中一整个 block,也要为它的邻居付出容量;token 级选择则可以把这份预算分配到横跨上下文的单个位置上。检索与图推理的增益与这个解释是一致的。
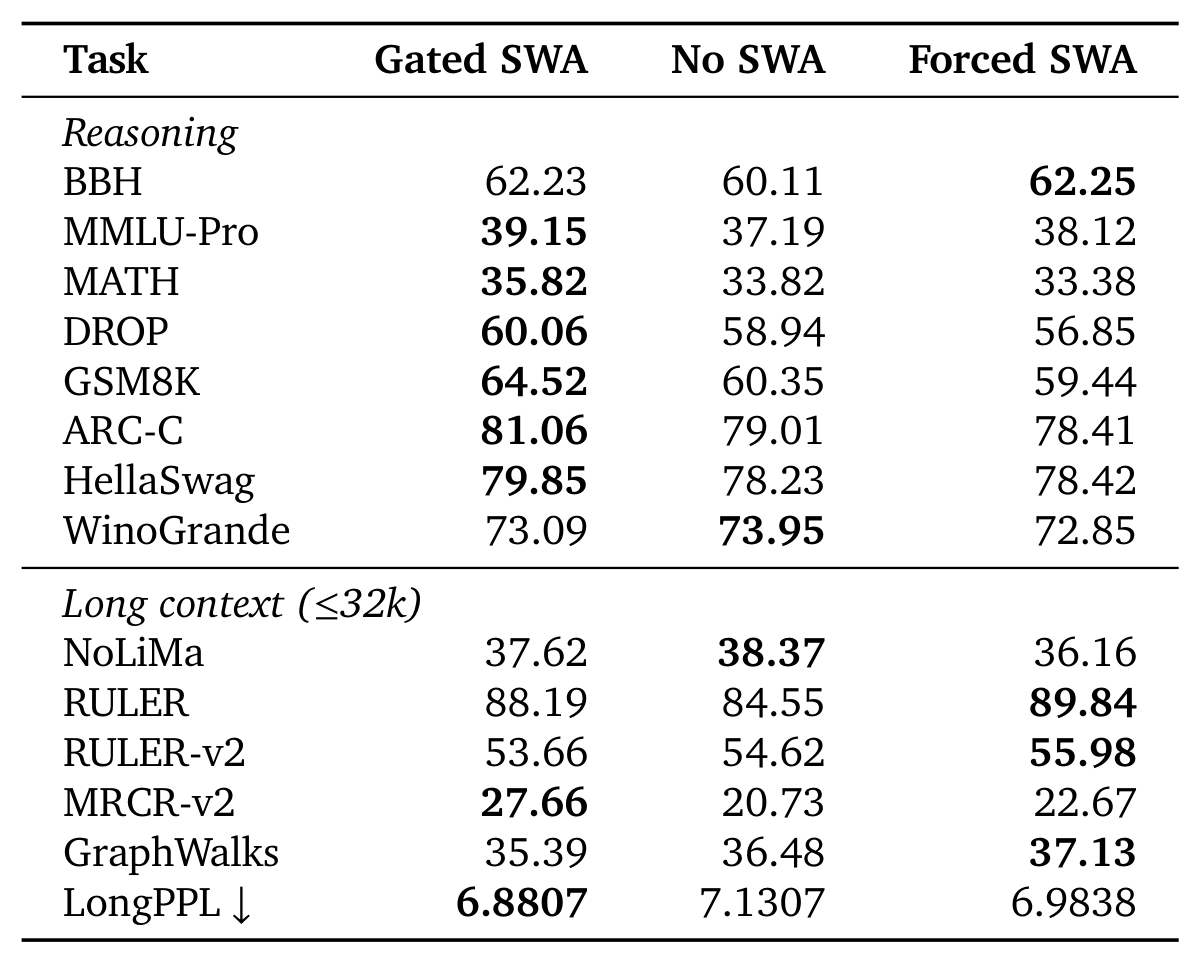
7.2 局部窗口:强制入选 vs 独立分支
7.3 KV Bridging:能不能白拿 prefill 收益
最关键的验证是:KV Bridging 主要为加速 prefill 而设计,那它会不会伤质量?论文直接做了两个方向的对照。
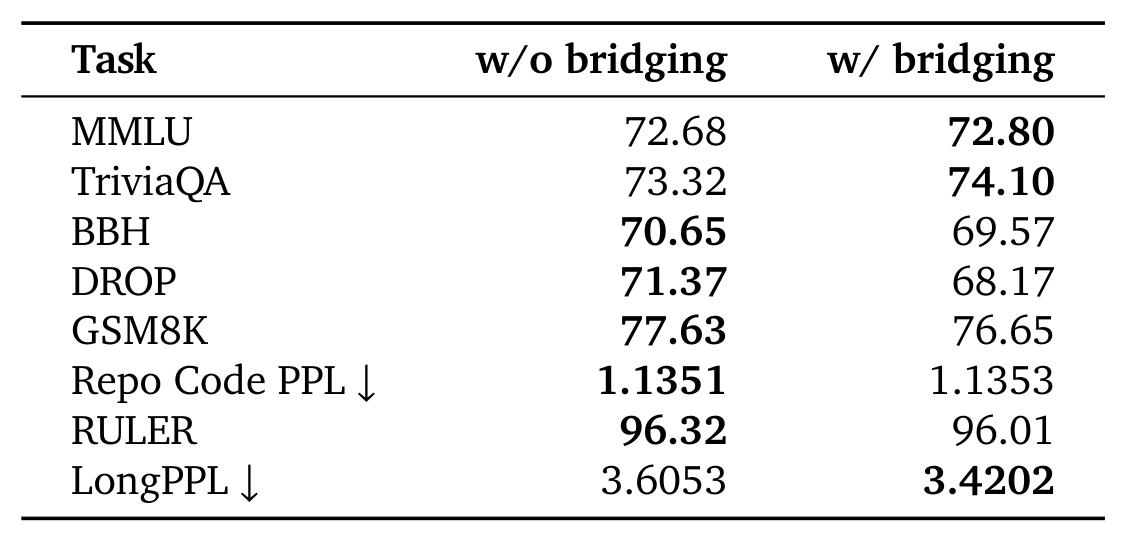
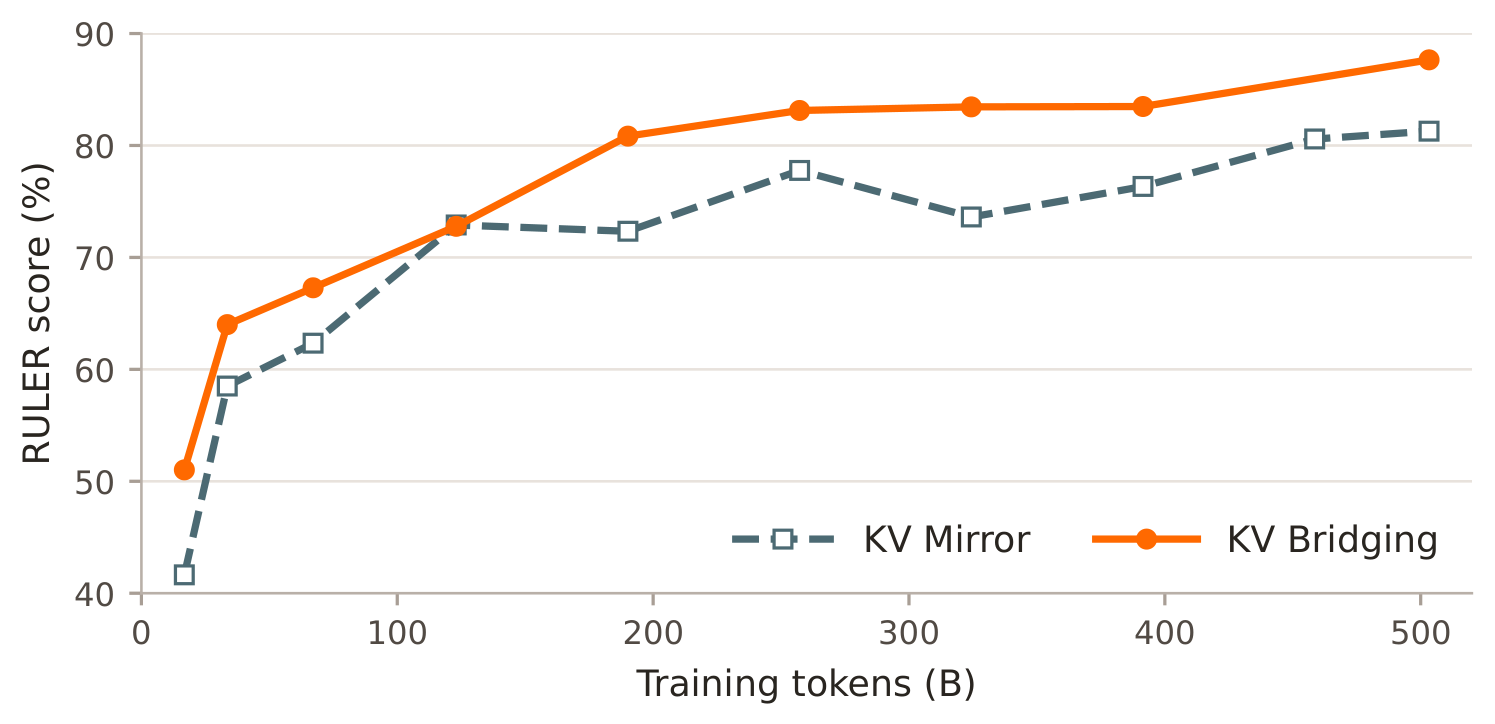
第二个方向是"连接方案本身"的选择。论文把 KV Bridging 与 KV Mirror(Liu et al., 2026)在同一条 hybrid backbone、同一套预训练配方下对比:
点评:亮点、局限与要留意的账
亮点
- 论证是闭合的,不是技巧堆叠。论文没有停在"我们省了 FLOPs",而是把因果链走完:独立 SWA 分支 → 依赖 cross-decoder 自身隐状态 → 级联依赖使 token 后缀随深度增长 → cross-decoder 无法跳过 → 因此必须把局部性改写成"选择集合的固定成员"。这个次序让"prefill 只跑半个模型"成为可推导的结论,而不是一句断言。
- 消融的控制条件干净。7.1 的两组做到同 backbone、同 1,024 全局预算、同 128 局部窗口,只动选择单位;7.2 的三组共享 backbone、KV Bridging 与 self-decoder,只动 cross-decoder 的局部性处理方式。这类"一次只动一个变量"的对照在小节里并不多见。
- 关键机制在更大规模上复验。KV Bridging 的消融放在 290B-A8B / 约 1.8T tokens 上做,而不是只在 80B 上 —— 架构类论文里这一步常被省略。
- 对参照基线足够诚实。论文明确写出"每层全注意力是最强参照""Hybrid SWA 需要 9 个全注意力层,更少会明显掉精度""HySparse2 在 DROP 上不如 HySparse",没有回避反向结果。
- 架构约束与部署约束讲的是同一套语言。prefill 节点只装 25 层、因为投影后的 KV 比源隐状态小所以传 KV —— 设计决策直接对应到部署决策,读者能算出它值多少钱。
- 留了可测的下一步。提出在 FA 层减少 query 头数、在 SA 层增加 query 头数,把计算进一步推向稀疏端 —— 这是一个明确、可证伪的方向。
局限与读时要注意的账
- "broadly comparable" 的真实内容。Table 2 里 HySparse2 相对 HySparse 在 DROP 上低 4.79 分、GSM8K 低 2.20、MATH 低 1.82、WinoGrande 低 2.37;相对 Hybrid SWA 在 MBPP+ 上低 2.91、DROP 低 1.91。通用能力的代价主要落在推理与代码类任务上,论文只用"a mixed picture"一句概括。
- 精度代价集中在它自己主推的指标上。7.2 显示 Forced SWA 相比 Gated SWA 在 MRCR-v2 上低 4.99 分、GSM8K 低 5.08 分、LongPPL 差 1.50%。而 MRCR-v2 正是本文用来证明检索更强的两个核心指标之一,GSM8K 又属推理能力。论文称这个交换可接受,理由是把"参数与本地 KV cache"换成了"可提前退出",但读者需要自己判断这笔交易是否划算。
- 粒度消融里的反向结果未被讨论。Table 3 中 NoLiMa(40.27 vs 38.43)与 BBH(61.93 vs 60.70)都是 block 级更好,正文未提及这两项。
- KV cache 优势里混着 head 配置的功劳。HySparse2 用 MQA 64/1 而两个 baseline 用 GQA 64/4(Table 1),因此 6.4 节的体积优势并非纯粹来自跨层共享。论文未提供同为 MQA 或同为 GQA 的分离对照。按本页推算,若忽略 head 配置差异,"5 层 FA 对 9 层 FA"只能解释 $9/5 = 1.8\times$,而非观测到的 4.49×。
- 消融的上下文长度与动机不匹配。7.1 的动机是长程多轮的 agentic 检索,但消融只在 32k 训练上下文内做(论文自己也写明 "These gains are present within the 32k training context")。256k 下的同一对照仍待补测。
- 成本全是账面量。全文的成本结论建立在 FLOPs 与 KV cache 字节数上,没有端到端的吞吐或时延实测;token 级稀疏声称的 kernel 效率优势同样没有实测支撑。5.2 的推测解码部分是一条可能性论证,论文明确标注为未来工作。
- 部分指标不可跨论文比较。AgentPPL 与 Repo Code PPL 是内部基准;LongPPL 使用了 349 个样本的具体选法、MRCR-v2 的 needle 组合方式,论文只给了粗粒度描述。这些数字在本篇内部对照是有效的,但不宜直接与其他论文的同类指标并列。
技术来源一览
本页把论文正文里出现的技术来源按组件整理成一张表,便于看清"哪些是这一代新做的、哪些是继承并改造的"。
| 组件 / 决定 | 论文标注的上游 | 这一代的改造 |
|---|---|---|
| 双解码器骨架 + prefill 提前退出 | YOCO(Sun et al., 2024);Gemma 3n 的相关跨层共享(Sanseviero and Ballantyne, 2025) | KV Bridging 只连全注意力层,允许两个 decoder 用不同混合比例,一个 self-decoder FA 层供给 4 个 cross-decoder FA 层 |
| hybrid block 内的跨层 KV / 索引共享 | HySparse(Gao et al., 2026) | 保留为内层 KV Reuse;选择单位由 64-token block 改为单个 token |
| 无独立 indexer 的 oracle 选择 | HySparse(Gao et al., 2026);对照路线:SeerAttention(Gao et al., 2024)、DeepSeek-AI et al. (2025) | 对单 token 做 top-$k$;不需要蒸馏 auxiliary indexer,端到端原生训练 |
| 局部性处理 | HySparse 的独立 gated SWA 分支(Gao et al., 2026) | 删除该分支,改为把最近 128 token 强制纳入稀疏选择;局部性由共享 KV cache 提供 |
| 被明确否定的替代方案 | bounded replay(DeepSeek-AI, 2026) | 不用近似,而是从结构上消除 cross-decoder 对自身隐状态的依赖 |
| token 级稀疏的 kernel 可行性 | TileLang(Wang et al., 2025) | 以此论证 token 级选择在工程上已经可行 |
| KV head 配置 | MQA(Shazeer, 2019);GQA(Ainslie et al., 2023) | 改用 MQA 64/1(baseline 为 GQA 64/4),换更小 KV cache 与更好的 token 稀疏 kernel 效率 |
| 位置编码 | RoFormer / 部分 RoPE(Su et al., 2024);NoPE | SWA 层用 64 维部分 RoPE(base 10,000);全与稀疏层用 NoPE → 长上下文扩展不需调 RoPE |
| 注意力后处理 | sigmoid 输出门(Qiu et al., 2025);per-head sink bias(Agarwal et al., 2025) | 所有稀疏层与 SWA 层统一使用 |
| 骨干与残差 | mHC(Xie et al., 2026;Zhu et al., 2025) | 简化变体,残差混合矩阵固定为单位阵 |
| 优化与日程 | Muon(Jordan et al., 2024) | WSD 日程;峰值学习率 $10^{-3}$(预训练)/ $5\times10^{-5}$(后训练) |
| 跨层连接方案对照 | KV Mirror 的 U 型配对(Liu et al., 2026) | 改为只连全注意力层;论文报告终值 RULER 87.65 vs 81.28 |
| 推测解码 / MTP | DFlash(Chen et al., 2026);异步起草与验证(Zhang et al., 2025) | MTP 层条件在 self/cross 边界隐状态上;换更大 drafter 属未来工作 |
| 长上下文似然指标 | LongPPL(Fang et al., 2024) | 沿用;AgentPPL 为本文内部基准 |
| 评测集 | MRCR(Vodrahalli et al., 2024);RULER-v2(Hsieh et al., 2025);GraphWalks(OpenAI, 2025);NoLiMa(Modarressi et al., 2025) | — |
引用为论文行内标注口径,本页未逐条核对参考文献条目。
未披露、值得补测的点
- token score 的算法。论文说全注意力层用"精确注意力分数"为后续稀疏层提供 oracle 选择,Figure 2 也只标注 "token scores" 与 "Token Top-k"。但跨 query 位置、跨 query 头如何聚合成每个 KV token 的单一分数(用哪种统计量、是否只取特定 query、是否做额外归一)未见披露 —— 这直接决定 indexer 的开销,也是复现时的第一个卡点。
- 端到端吞吐与时延。全文只给 FLOPs 与 KV cache 字节数(全文检索未见 throughput / latency / TTFT 等字样),值得补一组真实 kernel 上的 prefill 时延与 decode 吞吐,尤其是在 1M 上下文、prefill 节点只装 25 层的分离式部署下。
- prefill → decode 的 KV 传输开销。论文选择在 prefill 节点算出 cross-decoder FA 的 KV 再传给 decode 节点,理由是"投影后的 KV 比源隐状态小"。传输量、带宽受限时的实际收益、以及它与"prefill 只装 25 层"的联合收益,均未见量化。
- 强制窗口的敏感性。窗口固定 128、全局 1,024,论文未给窗口大小与预算的敏感性扫描。考虑到 Forced SWA 在 MRCR-v2 上比 Gated SWA 低 4.99 分,值得试更长的窗口、或窗口内加门的变体,看能否把这一项补回来。
- 256k 上的粒度消融。token vs block 的对照只在 32k 训练上下文内完成,而设计的动机是 256k 的多轮 agentic 检索;把同一对照搬到长上下文、并复现 Table 3 中 NoLiMa 与 BBH 的反向结果,是判断"token 级是否普遍更优"的关键一步。
- 分离 head 配置与跨层共享的贡献。值得补一组"同为 MQA"或"同为 GQA"的对照,把 KV cache 与 kernel 效率的收益拆成"跨层共享"与"KV head 数"两部分。
术语速查
阅读中遇到缩写可随时回到这里;正文里带虚线下划线的缩写也可悬停查看释义。
| 缩写 / 术语 | 全称 | 一句话解释 |
|---|---|---|
| FA | Full Attention | 全注意力:每个 query 可以看到全部历史,精度最高、成本最高;本文中只有 5 层 |
| SWA | Sliding-Window Attention | 滑窗注意力:只关注最近固定窗口,负责局部建模;本文 self-decoder 有 24 层 |
| SA | Sparse Attention | 稀疏注意力:每个 query 只关注被选中的一部分 KV 条目;本文 cross-decoder 有 20 层 |
| KV Bridging | — | 本文外层共享:cross-decoder 的 FA 层用 self-decoder FA 层的输入隐状态,经各自投影构造自己的 K/V |
| KV Reuse | — | 本文内层共享:同一 hybrid block 里,SA 层复用 FA 层的 KV cache 与选择索引 |
| KV Mirror | — | 对照的跨层连接方案:早层与晚层反序 U 型配对($1 \rightarrow n$、$2 \rightarrow n-1$);Figure 5 中 RULER 低于 KV Bridging |
| hybrid block | — | 本文中指 "FA + SA×5" 这样一段混合注意力的层组;cross-decoder 由 4 组构成 |
| cascading SWA dependency | — | 级联 SWA 依赖:独立 SWA 分支的 KV 需要自己的隐状态后缀,而该后缀又依赖更早层,所需长度随深度线性增长 —— 这是 cross-decoder 不能跳过的根因 |
| block-level / token-level | — | 稀疏选择的粒度:以 64 token 的块为单位,还是以单个 token 为单位。本文从前者改为后者 |
| forced local window | — | 强制局部窗口:把最近 128 个 token 无条件纳入稀疏选择集合,替代独立的 SWA 分支 |
| indexer | — | 索引器:预测哪些 KV 值得被选中的模块。本文由 FA 层兼任,无需单独训练 |
| oracle token selection | — | 用精确注意力分数(而非近似模块)给出的选择信号 |
| gated fusion | — | 门控融合:HySparse 把稀疏注意力与独立 SWA 分支的输出按门控加权合并;HySparse2 取消了这一结构 |
| sink bias | — | 可学习的 per-head 偏置,缓解注意力汇聚(attention sink)现象 |
| YOCO | You Only Cache Once | 用 self-decoder 构造一份全局 KV cache 供 cross-decoder 复用的架构;prefill 可在 self-decoder 后退出 |
| MQA / GQA / MLA | Multi-Query / Grouped-Query / Multi-head Latent Attention | 三种 head 维 KV 压缩方式:全部 query 头共享 1 组 KV / 分组共享 / 压进隐状态。本文 HySparse2 用 MQA 64/1 |
| RoPE / NoPE | Rotary / No Positional Embedding | 旋转位置编码 / 不用显式位置编码。本文仅 SWA 用 64 维部分 RoPE |
| MoE | Mixture-of-Experts | 混合专家;80B-A3B 指总参数 80B、每 token 激活约 3B |
| mHC | Manifold-constrained Hyper-Connections | 残差连接的一种改造;本文用简化变体,残差混合矩阵固定为单位阵 |
| MTP | Multi-Token Prediction | 多 token 预测层,可作推测解码的 drafter;本文条件在 self/cross 边界隐状态上 |
| Prefill / Decode | — | 推理的两个阶段:对已有输入做一次前向建 KV cache / 逐 token 自回归生成 |
| Prefill–Decode Disaggregation | — | 把两阶段拆到不同节点,各自按资源特征优化;本文 prefill 节点只需装 25 层 |
| FP8 | 8-bit Floating Point | 本文 KV cache 体积数字的精度口径(1 字节/元素) |
| GFLOPs / token | — | 每 token 的十亿次浮点运算数,prefill 计算量的度量 |
| PPL | Perplexity | 困惑度,越低越好;AgentPPL / LongPPL / Repo Code PPL 为三种不同口径 |
| AgentPPL | — | 本文内部基准:对 1,000 条多轮 agent 轨迹的 reasoning / tool-call / response 三段报告 byte perplexity |
| LongPPL | — | 只在依赖长程上下文的被选 token 上算 perplexity(Fang et al., 2024);本文用 349 个样本 |
| needle | — | 检索评测里埋进长文档的"针";MRCR-v2 用 2/4/8 needle 的多轮设置 |
| RULER / RULER-v2 | — | 长上下文基准;v2 覆盖 12 个检索与问答子任务 |
| MRCR-v2 | — | 多轮检索基准(Vodrahalli et al., 2024 的 MRCR 后续口径) |
| GraphWalks | — | 多跳图遍历评测(OpenAI, 2025),探测跨段落的多步推理式检索 |
| bounded replay | — | 一种用有限长度重放来近似所需隐状态的方法;本文选择从结构上避免它的需要 |